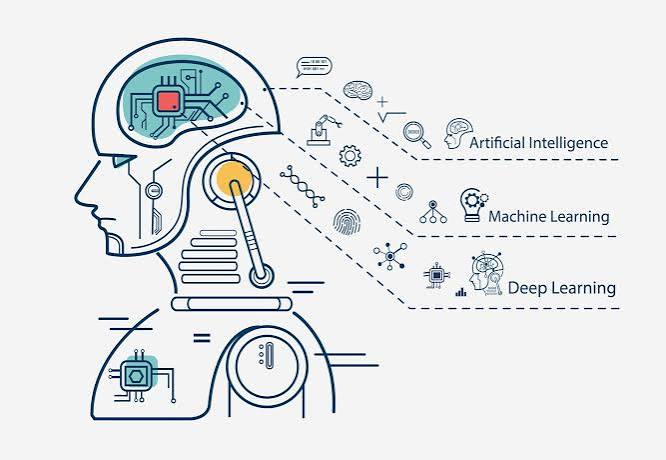
در قلب بسیاری از فناوریهایی که امروزه از آنها استفاده میکنیم، از موتورهای جستجو گرفته تا دستیارهای صوتی گوشی هوشمند، یک مفهوم کلیدی نهفته است: یادگیری ماشین یا Machine Learning. اما این اصطلاح پیچیده دقیقاً به چه معناست؟ به زبان ساده، یادگیری ماشین شاخهای از هوش مصنوعی است که به سیستمها این امکان را میدهد تا بدون برنامهریزی مستقیم و صرفاً با استفاده از دادهها، الگوها را شناسایی کرده و عملکرد خود را بهبود بخشند. تفاوت اساسی آن با برنامهنویسی سنتی در این است که به جای نوشتن قوانین صریح برای کامپیوتر، به آن داده میدهیم و از آن میخواهیم خودش قوانین را کشف کند.
برای درک بهتر این مفهوم، بیایید نگاهی به انواع مختلف یادگیری ماشین بیندازیم. رایجترین روش، یادگیری نظارتشده (Supervised Learning) است. در این روش، مدل با استفاده از دادههای برچسبخورده آموزش داده میشود؛ یعنی به ازای هر ورودی، خروجی صحیح آن نیز به مدل داده میشود. برای مثال، اگر بخواهیم مدلی بسازیم که ایمیلهای اسپم را تشخیص دهد، هزاران ایمیل را به همراه برچسب «اسپم» یا «غیر اسپم» به آن میدهیم. مدل با تحلیل این دادهها، الگوهای موجود در ایمیلهای اسپم را یاد میگیرد و سپس میتواند برای ایمیلهای جدید و ندیده، پیشبینی کند که آیا اسپم هستند یا خیر. این نوع یادگیری خود به دو دسته اصلی تقسیم میشود: طبقهبندی (Classification) که خروجی آن یک دستهبندی گسسته است (مثل اسپم یا غیراسپم) و رگرسیون (Regression) که خروجی آن یک مقدار عددی و پیوسته است (مثل پیشبینی قیمت مسکن).
در مقابل، یادگیری بدون نظارت (Unsupervised Learning) با دادههای بدون برچسب سروکار دارد. در اینجا، خود مدل باید الگوها و ساختارهای پنهان در داده را کشف کند. یک مثال کلیدی، خوشهبندی (Clustering) است که در آن مدل، دادههای مشابه را در گروههای مجزا (خوشه) قرار میدهد. به عنوان مثال، یک فروشگاه اینترنتی میتواند از این روش برای گروهبندی مشتریان بر اساس رفتار خریدشان استفاده کند تا برای هر گروه، تبلیغات هدفمندتری ارسال کند. کاهش ابعاد (Dimensionality Reduction) نیز یکی دیگر از کاربردهای این نوع یادگیری است که برای سادهسازی دادهها و حذف ویژگیهای کماهمیت به کار میرود.
فراتر از این دو، رویکردهای دیگری نیز وجود دارند. یادگیری نیمهنظارتشده (Semi-supervised Learning) ترکیبی از دو روش قبل است و زمانی کاربرد دارد که فقط مقدار کمی داده برچسبخورده و حجم زیادی داده بدون برچسب در دسترس باشد. همچنین یادگیری تقویتی (Reinforcement Learning) روشی کاملاً متفاوت است؛ در اینجا، یک عامل (Agent) با قرار گرفتن در یک محیط، از طریق آزمون و خطا و دریافت پاداش یا جریمه برای هر اقدام، یاد میگیرد که بهترین تصمیمات را برای رسیدن به یک هدف بگیرد. این روش در بازیهای رایانهای، رباتیک و سیستمهای خودران کاربرد گستردهای دارد.
انتخاب مدل مناسب، یکی از مهمترین گامها در یک پروژه یادگیری ماشین است. هر مدل، نقاط قوت و ضعف خاص خود را دارد. برای مثال، مدل درخت تصمیم (Decision Tree) که بسیار قابل تفسیر است و میتوان آن را به راحتی تجسم کرد، با افزایش عمق ممکن است بیش از حد بر روی دادههای آموزشی پرحافظه (Overfit) شود و روی دادههای جدید عملکرد ضعیفی داشته باشد. در مقابل، مدل ماشین بردار پشتیبان (SVM) با استفاده از ترفند هسته (Kernel Trick)، برای دادههای با ابعاد بالا بسیار قدرتمند است، اما به عنوان یک جعبه سیاه (Black-box) شناخته میشود و تفسیر نتایج آن دشوارتر است. در نهایت، صرفنظر از نوع مدل، یک اصل حیاتی در همه پروژههای یادگیری ماشین، تقسیم دادهها به دو مجموعه آموزش و آزمایش است تا بتوانیم عملکرد مدل را روی دادههای جدید و ندیده، به درستی ارزیابی کنیم.
با وجود تمام پیشرفتها و کاربردهای گسترده، یادگیری ماشین نوشداروی همه مشکلات نیست. استفاده از آن زمانی منطقی است که با دادههای پیچیده و حجیم روبرو باشیم و قوانین حاکم بر مسئله بهوضوح قابل تعریف نباشند یا بسیار پیچیده باشند. در بسیاری از موارد، یک سیستم قانونمحور (Rule-based) ساده یا حتی تکیه بر قضاوت انسانی، کارآمدتر و اخلاقیتر است. به هر حال، درک مفاهیم پایهای یادگیری ماشین، نه تنها برای متخصصان، بلکه برای هر شهروند عصر دیجیتال، کلیدی برای درک دنیای پیرامون و فناوریهای نوظهوری است که زندگی ما را شکل میدهند.